La digestión de los libros: cómo las tecnológicas compran, escanean y destruyen bibliotecas físicas
La historia que define por qué el conocimiento está dejando de ser un documento para convertirse en un peso probabilístico: Project Panama de Anthropic y el mercado de libros físicos para entrenar modelos.

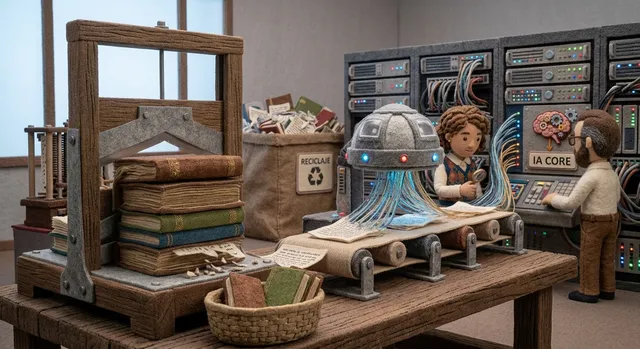
Esta es la historia que define por qué el conocimiento está dejando de ser un documento para convertirse en un peso probabilístico.
No es un algoritmo descargando páginas web. Es una empresa comprando millones de libros de segunda mano, cortándoles el lomo con una guillotina hidráulica, escaneando las páginas sueltas a velocidad industrial y enviando el papel al reciclaje. Ninguna copia física sobrevive. El libro se convierte en tokens de entrenamiento y tú, años después, pagas por leer su interpretación.
Esto no es una metáfora. Es lo que ocurrió con Project Panama y lo que un mercado entero está institucionalizando.
La web ya no es un corpus limpio
Durante años, las empresas de IA entrenaron sus modelos con el texto de la web abierta. Ese material se ha agotado y, sobre todo, se ha contaminado.
Cuando un modelo se entrena con texto generado por otro modelo, sus resultados se degradan en un ciclo conocido como model collapse: primero desaparecen las respuestas raras o minoritarias de la distribución, después empeora la calidad general del output, y esa segunda fase no se corrige con ajuste fino. El mecanismo fue formalizado por Shumailov y sus colegas de Oxford, Cambridge y Toronto en un artículo publicado en Nature en 2024.
Por si fuera poco, los autores que se oponen a ser escaneados han empezado a usar herramientas de data poisoning: perturbaciones invisibles incrustadas en el texto que sabotean el entrenamiento del modelo.
74%
de las páginas web creadas contenían texto generado por IA a principios de 2025, según estimaciones de la industria.
50
muestras envenenadas en un lote de 100.000 bastan para degradar los resultados de un modelo, como demostró Nightshade (Univ. de Chicago, 2024).
500
documentos cuidadosamente redactados pueden plantar un backdoor en un corpus de billones de tokens, según investigación de Anthropic citada por ISBNdb.
Frente a esto, los libros impresos publicados antes de la eclosión de los LLM ofrecen una garantía estructural: no contienen texto generado por IA y no han podido ser modificados por herramientas de envenenamiento. Son la materia prima "pura" que la web ya no puede aportar.
Project Panama: la operación que guillotinó los libros
En enero de 2026, The Washington Post reconstruyó, a partir de más de 4.000 páginas de documentos judiciales desclasificados, la operación con la que Anthropic obtuvo datos de libros a escala industrial.
El proyecto, bautizado internamente como Project Panama, arrancó a principios de 2024. Un documento de planificación interno lo definía sin rodeos: "Project Panama is our effort to destructively scan all the books in the world", y pedía expresamente mantenerlo en secreto. Anthropic gastó decenas de millones de dólares comprando libros usados en lotes de decenas de miles de ejemplares, procedentes de vendedores como Better World Books o World of Books.
El proceso era industrial e irreversible:
1 · Compra en lote
Miles de ejemplares de segunda mano comprados de golpe, sin que el vendedor sepa quién los adquiere.
2 · Guillotina hidráulica
Máquinas de corte quitan el lomo del libro para dejar las páginas sueltas.
3 · Escaneo industrial
Las páginas pasan por escáneres de producción con una precisión OCR declarada superior al 99,5%.
4 · Reciclaje
El papel se destruye. No queda ninguna copia física del libro.
Las propuestas de los vendors evaluadas por Anthropic hablaban de convertir entre 500.000 y 2 millones de volúmenes en seis meses, un ritmo de varios miles de libros por día laborable. El papel se enviaba a reciclaje: el proceso era deliberadamente irreversible y no dejaba archivo físico detrás.
500K–2M
libros que buscaban escanearse en seis meses, según los vendors propuestos por Anthropic.
7M+
libros descargados por el cofundador Ben Mann de bibliotecas piratas (LibGen, PiLiMi, Books3) en 2021.
$1.5B
de acuerdo de Anthropic con los autores por la parte pirateada, en agosto de 2025 (~$3.000 por obra).
>99,5%
de precisión OCR declarada en los escáneres de producción usados para las páginas sueltas.
ISBNdb: la librería invisible para las IA
La práctica no es exclusiva de Anthropic. En julio de 2026, la investigación de 404 Media destapó un mercado intermediario completo en torno a esta demanda: libros físicos antiguos como fuente de entrenamiento "limpia".
El protagonista era ISBNdb, una empresa con más de dos décadas gestionando una base de datos bibliográfica de unos 112 millones de títulos catalogados. Tras la eclosión de la IA, además de vender metadatos, empezó a ofrecer un servicio de "Printed Books Sourcing for Your AI LLMs Dataset Needs": lotes de entre 1.000 y un millón de libros por pedido, con un NDA estricto en cada compromiso y la promesa de que "your identity, strategy, and targets are never disclosed".
El argumentario comercial era tan explícito como incómodo:
ISBNdb · argumento de venta
"The world's best AI training data is sitting on a shelf. Books represent curated, peer-reviewed, domain-specific human knowledge, structured in a way no web crawl can replicate. Dense, edited, authoritative."
ISBNdb · el problema de imagen
"The optics problem is real. 'AI company destroys two million books' is not a headline that generates sympathy."
ISBNdb · el lavado de conciencia
"Responsible physical sourcing is not book burning. It is the completion of a book's lifecycle: from tree to knowledge to tree again."
El impacto fue inmediato. Libreros de todo el mundo vieron pedidos masivos y anónimos: uno de ellos pasó de vender menos de 20 libros a la semana a centenares desde abril de 2026; a las librerías holandesas llegaron pedidos de 3.001 títulos de golpe, con una "total falta de respeto por el precio". Los compradores pagaban sobreprecios por libros raros y descatalogados que después eran pulpeados.
Nueve días después de la publicación de 404 Media, ISBNdb retiró la página del servicio. El 30 de julio de 2026 negó haber comprado, escaneado o vendido un solo libro y lo calificó de "una prueba de interés de mercado". No hubo regulador, ni corte, ni aviso institucional de por medio: solo el periodismo. Y el mercado legal que lo sustentaba quedó intacto.
21 jul 2026
404 Media publica la investigación sobre ISBNdb y el mercado de libros para entrenar modelos.
30 jul 2026
ISBNdb retira la página, niega haber vendido nunca y lo llama "test de mercado". El mercado legal sigue en pie.
El incentivo legal y económico
¿Por qué comprar y destruir papel en vez de licenciar libros o usar las bibliotecas digitales existentes? La respuesta es una combinación de derecho y economía.
La compra de un ejemplar físico se rige por la first sale doctrine (17 U.S.C. § 109): el comprador puede hacer con su copia lo que quiera, incluido destruirla. Y en junio de 2025, el juez federal William Alsup resolvió en el caso Bartz v. Anthropic que escanear un libro comprado legalmente y usar el texto para entrenar un modelo es fair use: el uso es transformativo y la copia digital reemplaza a la copia física destruida, sin que se genere una copia adicional.
La sentencia, eso sí, dibujó una línea clara: el fair use cubría los libros comprados, pero no los más de siete millones de libros descargados de bibliotecas piratas por Ben Mann. Esa parte costó a Anthropic 1.500 millones de dólares en un acuerdo con los autores, el mayor del que se tiene constancia en la historia del copyright de Estados Unidos, a razón de unos 3.000 dólares por obra.
Leer las dos decisiones juntas produce un incentivo preciso: comprar papel de segunda mano y destruirlo tras el escaneo cuesta una fracción de lo que costaría licenciar el contenido y, además, blinda contra la litigación. No es que las empresas de IA odien los libros: es que el papel, como soporte, es el envoltorio legal y económico perfecto para convertirlo en datos.
Por qué te debería importar
Puede parecer una historia lejana de documentos judiciales, pero toca directamente lo que hago como profesional del conocimiento y lo que ya expliqué en Resolver más, aprender menos: mientras cada vez más personas delegamos en los modelos el proceso de aprender, la industria busca desesperadamente conocimiento humano original para entrenarlos.
El conocimiento público impreso está siendo comprado, digerido y devuelto bajo un modelo de suscripción pagado en tokens. Si no queda una copia física para auditar lo que el modelo responde, la única versión disponible del pasado pasa a vivir en un servidor privado, sin pegamento de Moscú ni error 404 que nos haga sospechar. Esa es exactamente la pregunta que exploro en El último libro en la estantería, y también la otra cara de la moneda que analicé en Si la IA multiplica tu productividad, ¿quién se queda el beneficio?: la memoria colectiva, como la productividad, tiene dueño.
Fuentes oficiales
- 404 Media - AI Companies Are Buying Tons of Old Books Because They're Free of AI Slop (Jul 2026)
- The Washington Post - Inside Project Panama: Anthropic destructively scanned millions of books to build Claude (Ene 2026)
- 404 Media - Company Offering Printed Books to Train AI Stops After Coverage (Jul 2026)
- TechSpot - AI firms are quietly buying and destroying millions of printed books to train their models (Jul 2026)
- IBTimes UK - Inside Project Panama: Anthropic's secret effort to scan and shred the world's books (Jul 2026)
- Shumailov et al. - AI models collapse when trained on recursively generated data (Nature, 2024)
AI Engineer en Unit4. Construyo software inteligente y escribo sobre tecnología, productividad y el impacto de la IA en el día a día del desarrollador.