El último libro en la estantería: la privatización de la memoria colectiva
De la censura que dejaba cicatriz a la IA que destruye el papel para sintetizar la verdad. Qué ocurre cuando el conocimiento pasa de ser un documento público a un peso probabilístico en un servidor privado.

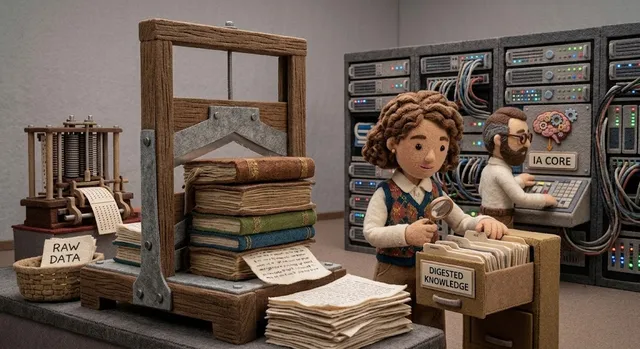
De la censura que dejaba cicatriz a la IA que destruye el papel para sintetizar la verdad. Qué ocurre cuando el conocimiento pasa de ser un documento público a un peso probabilístico en un servidor privado.
La policía de la memoria
En la novela La policía de la memoria, de la escritora japonesa Yōko Ogawa, los habitantes de una isla sufren la desaparición gradual de cosas cotidianas: primero los pájaros, luego las fotografías, después los mapas. Lo verdaderamente inquietante de la historia no es la pérdida del objeto físico, sino que, al poco tiempo de desaparecer, la gente olvida que alguna vez existió. Para asegurar que nadie intente recordar, una policía secreta vigila y borra cualquier rastro del pasado.
Durante siglos, cambiar el relato o censurar la historia requería un despliegue físico brutal: hogueras, guillotinas de papel, tijeras y un ejército de funcionarios. Cuando la Rusia soviética quiso borrar al caído en desgracia Lavrenti Beria de la Gran Enciclopedia Soviética, la editorial envió a los suscriptores páginas de recambio sobre el estrecho de Bering para pegarlas encima. Pero la censura analógica dejaba cicatriz: el corte de la cuchilla y el pegamento revelaban que allí se había ocultado algo.
Link rot: una web que se desvanece en tiempo real
Tendemos a pensar en la web como un archivo infinito e inmutable, pero la realidad técnica es que internet se está desintegrando a una velocidad pasmosa. Según datos del Pew Research Center, el 38% de las páginas web que existían en 2013 han desaparecido hoy. De todo el contenido generado en la última década (2013-2023), una de cada cuatro páginas ya no existe. Es lo que en computación se conoce como link rot o la podredumbre del enlace.
En la web tradicional, este fenómeno tenía un rostro claro y honesto: el error 404 Page Not Found.
El 404 era la "nada visible". Un mensaje áspero, pero transparente: te avisaba de que allí hubo un documento, una noticia, una investigación o un debate que alguien decidió borrar o dejar morir. En sitios gubernamentales y medios de comunicación, más del 20% de las fuentes citadas hoy devuelven un 404. La memoria digital se estaba evaporando, pero al menos dejaba la cicatriz del enlace roto.
Sin embargo, el verdadero drama para la industria de la inteligencia artificial ocurrió cuando la podredumbre del enlace colisionó con la eclosión de los LLM. Las Big Tech se encontraron con una web acorralada por dos fuegos:
- La web antigua desaparece bajo errores 404.
- La web nueva se inunda de AI slop: contenido sintético de baja calidad generado por las propias IA para posicionar en buscadores.
Si entrenas un modelo de lenguaje con la web actual, lo estás entrenando con una mezcla de enlaces muertos y sus propios residuos. El 404 en el mundo digital es, precisamente, lo que provocó la cacería en el mundo analógico: al no poder confiar en una web que se borra y se contamina a sí misma, las grandes tecnológicas tuvieron que salir a comprar, guillotinar y digerir los últimos soportes inmutables de conocimiento humano puro: los libros en papel anteriores a 2022.
De la web humana a la sintética
Lo inquietante no es solo que la web original se esté apagando bajo una lluvia de errores 404; lo verdaderamente crítico es qué está ocupando ese vacío. A medida que el registro humano desaparece por falta de mantenimiento o cambios de servidor, una nueva web está emergiendo a velocidad industrial con la IA al timón.
Hemos pasado de una internet de creadores a una internet de generadores. Espacio que deja libre un blog abandonado o un foro cerrado, espacio que coloniza una red de portales automatizados diseñados para captar impresiones y posicionar SEO con texto sintético.
Esta sustitución genera un fenómeno inédito: la web ha dejado de ser un reflejo de la experiencia humana para convertirse en un circuito cerrado de datos procesados por máquinas para otras máquinas.
Para las propias empresas de tecnología, esto ha creado una paradoja catastrófica. Si intentan entrenar a la próxima generación de modelos de lenguaje con la web actual, ya no están utilizando el conocimiento colectivo de la humanidad; están utilizando los residuos digestivos de la IA anterior. El riesgo de "colapso del modelo" (Model Collapse) por endogamia informativa es tan alto que la web viva ya no les sirve.
Por eso necesitaban el papel. Por eso necesitaban guillotinar los libros antiguos. Porque en un mundo donde la web moderna la escribe un algoritmo y la web antigua se borra con un 404, los libros pre-2022 se han convertido en el último yacimiento de petróleo no contaminado del planeta.
Para calibrar lo que está pasando ahora con los libros, conviene recordar Bebelplatz. En 1933, las Juventudes Hitlerianas quemaron en Berlín más de 20.000 libros en una pira pública. Casi un siglo después, esa imagen sigue siendo el símbolo por excelencia de la barbarie, y la condena es universal. Hoy, en cambio, las empresas de IA compran millones de libros de segunda mano, les cortan el lomo con guillotinas hidráulicas, escanean las páginas a velocidad industrial y mandan el papel al reciclaje. Todo con NDAs, camiones y logística. Y apenas genera debate. La diferencia no está en la destrucción, sino en la visibilidad: la quema nazi era un ritual público; la digestión industrial es logística invisible. Cuando ISBNdb, la empresa que suministra esos libros, asegura que "responsible physical sourcing is not book burning", protesta demasiado; su propia frase de venta, "the optics problem is real", delata que sabe exactamente cómo se llama esto en la historia.
Un acontecimiento que habría sido una revolución
Estamos ante un evento atroz. Si la quema de Bebelplatz sigue siendo, casi un siglo después, el símbolo universal de la barbarie, la digestión industrial de millones de libros (que hoy apenas genera debate) debería encender todas las alarmas. Si esto hubiera ocurrido en cualquier otra época, habría sido una completa revolución: conmoción pública, condena universal, libros prohibidos. Y sin embargo aquí estamos, viendo cómo se guillotina el papel a escala industrial bajo el silencio de los NDAs.
La Biblioteca de Alejandría pasó a la historia como el arquetipo de la pérdida del conocimiento, el desastre cultural por antonomasia. Hoy asistimos a una destrucción de mayor escala, y apenas levanta una columna de opinión. No es que la memoria colectiva valga menos que antes: es que ya no se reconoce cuando se destruye en silencio.
Porque no se trata solo de destruir soportes. Se está reescribiendo la historia, o al menos concentrándola: el conocimiento queda en un único punto de control donde puede ser editado pequeñamente, al gusto de quien lo gestiona. La censura que dejaba cicatriz (el pegamento de Moscú, el error 404) se convierte en una edición quirúrgica e invisible del registro completo del pasado.
Hoy nos adentramos en una tercera etapa, mucho más sutil: la era de la nada invisible.
El doble control: del servidor al átomo
Como advertía Julian Assange en 2010, la centralización de la información en grandes servidores cambió las reglas del juego. Si un medio o un servidor retira un archivo digital centralizado, el documento desaparece por completo del registro intelectual.
Sin embargo, en los últimos años hemos asistido a un doble movimiento que cierra el círculo entre el mundo digital y el mundo físico:
El control de la nube (los servidores): cuando consultamos a un asistente de IA, no obtenemos una lista de enlaces ni un error 404. Obtenemos una respuesta fluida, asertiva y sin costuras. Si la fuente original fue eliminada, modificada o desindexada antes del entrenamiento, la IA responderá igual de segura, omitiendo el pasado sin dejar rastro de la omisión.
El control de la materia (los libros físicos): como destapó 404 Media y desarrollé en profundidad en La digestión de los libros, las grandes compañías de IA han estado comprando masivamente toneladas de libros físicos publicados antes de la eclosión de los LLM. No buscan el texto de la web abierta (contaminado de AI slop o contenido sintético), sino la "pureza" del conocimiento humano pre-2022.
Para procesar esos libros a escala industrial, el método rápido implica guillotinar el lomo, separar las páginas, escanearlas y destruir el soporte físico.
Del documento público al peso probabilístico
Este proceso oculta una transformación profunda en la naturaleza del conocimiento:
- El libro en papel era un soporte descentralizado, inmutable y democrático. Estaba replicado en miles de estanterías y bibliotecas. Nadie podía cambiar el texto impreso en tu casa con una actualización remota.
- El modelo de IA absorbe ese texto, destruye el papel y diluye las palabras dentro de una matriz de miles de millones de parámetros matemáticos.
- El conocimiento deja de ser un documento al que se puede acotar o citar para convertirse en una interpretación sintética. Se produce así una privatización de la memoria: compramos el conocimiento público en papel, lo convertimos en datos de entrenamiento y lo devolvemos al usuario bajo un modelo de suscripción pagado en tokens.
La pérdida del contraste y la ilusión de saber
En Resolver más, aprender menos abordaba cómo la falta de fricción al resolver problemas con IA frena la construcción de nuestro propio mapa mental. Si a esto le añadimos la destrucción o desindexación de las fuentes originales, la situación se vuelve crítica para el profesional del conocimiento.
Si no recorremos el camino de la comprensión y, además, no existen las fuentes físicas o independientes para auditar la respuesta del modelo, ¿cómo sabremos si la IA está alucinando, aplicando un sesgo o reescribiendo una decisión técnica o histórica?
Nos arriesgamos a depender de un "sacerdocio tecnológico" que custodia la única versión disponible del pasado en sus servidores, sin pegamento de Moscú ni error 404 que nos haga sospechar.
La resistencia del archivo local
La tecnología aumenta la productividad, pero también reordena quién controla la memoria. Si la memoria digital se borra por abandono o por encargo, y la memoria física se digiere para entrenar modelos, la responsabilidad del registro vuelve a ser individual.
La archivista guerrillera: Marion Stokes
Antes de que existiera el término fake news, una bibliotecaria de Filadelfia llamada Marion Stokes lo entendió todo. El 4 de noviembre de 1979, durante la crisis de los rehenes en Irán, pulsó "grabar" en su Betamax y no se detuvo hasta su muerte en 2012: treinta y tres años, ocho videograbadoras funcionando en paralelo, más de 71.000 cintas y unas 400.000 horas de televisión. No lo hacía por nostalgia: sabía que las cadenas desechaban sus propios archivos para ahorrar costes de almacenamiento, y que quien controla el archivo controla la memoria. "Si no grabas la verdad, alguien más la escribirá por ti", decía. Su colección (hoy digitalizada en Internet Archive, con el documental Recorder: The Marion Stokes Project de 2019) es la prueba física de la tesis de este post: la resistencia del archivo local, en su forma más pura, la ejerció una sola persona.
La verdadera resistencia técnica en la era de la IA no es negarse a usar estas herramientas, sino cultivar dos hábitos esenciales:
- Custodiar la fuente: guardar en local, en papel o en redes descentralizadas aquello que consideramos fundamental. Mantener el libro en la estantería.
- Pedir la fuente: exigir auditoría y trazabilidad cuando una respuesta nos llega demasiado limpia.
La pregunta ya no es solo si la IA reemplazará parte de nuestro trabajo o si resolveremos más aprendiendo menos. La pregunta es si dentro de diez años podremos comprobar si lo que nos cuenta un modelo es real o solo la única versión que se le permitió conservar.
Fuentes y Referencias
Literatura / Ficción:
Pérdida de la web y censura:
- Pew Research Center (2024): When Online Content Disappears. Estudio sobre el "Link Rot" y el 38% de páginas desaparecidas desde 2013.
- Julian Assange - Discurso en el Oslo Freedom Forum (2010): la centralización de los archivos digitales en servidores únicos y la desaparición invisible del registro histórico.
- Marion Stokes (1979-2012): archivista de Filadelfia; más de 71.000 cintas de TV grabadas durante 33 años y donadas a Internet Archive. Documental Recorder: The Marion Stokes Project (2019, Matt Wolf).
Compra y destrucción de libros para IA:
- The Washington Post (enero de 2026): Inside Project Panama: Anthropic destructively scanned millions of books to build Claude. Reportaje a partir de 4.000 páginas de documentos judiciales desclasificados.
- 404 Media (julio de 2026): AI Companies Are Buying Tons of Old Books Because They're Free of AI Slop. Reportaje sobre la adquisición y digitalización/destrucción masiva de libros físicos pre-2022 por empresas de inteligencia artificial.
- 404 Media (julio de 2026): Company Offering Printed Books to Train AI Stops After Coverage. La retirada de la página de ISBNdb y su negativa posterior.
- Shumailov et al. (Nature, 2024): AI models collapse when trained on recursively generated data. Formalización del model collapse por endogamia informativa.
- La digestión de los libros (seed post con el detalle factual de Project Panama e ISBNdb).
Enlaces internos (Quantosh.es):
AI Engineer en Unit4. Construyo software inteligente y escribo sobre tecnología, productividad y el impacto de la IA en el día a día del desarrollador.